DiffusionGemma คืออะไร? AI ที่ไม่เขียนทีละคำ เร็วกว่าแต่แลกอะไร
AI ส่วนใหญ่เขียนทีละคำ แต่ DiffusionGemma ของ Google ร่างทั้งหน้าก่อนแล้วค่อยขัด ดูใน 30 วิ: ทำงานต่างกันยังไง เร็วขึ้นเท่าไหร่ เสียอะไร และควรเลือกตัวไหน
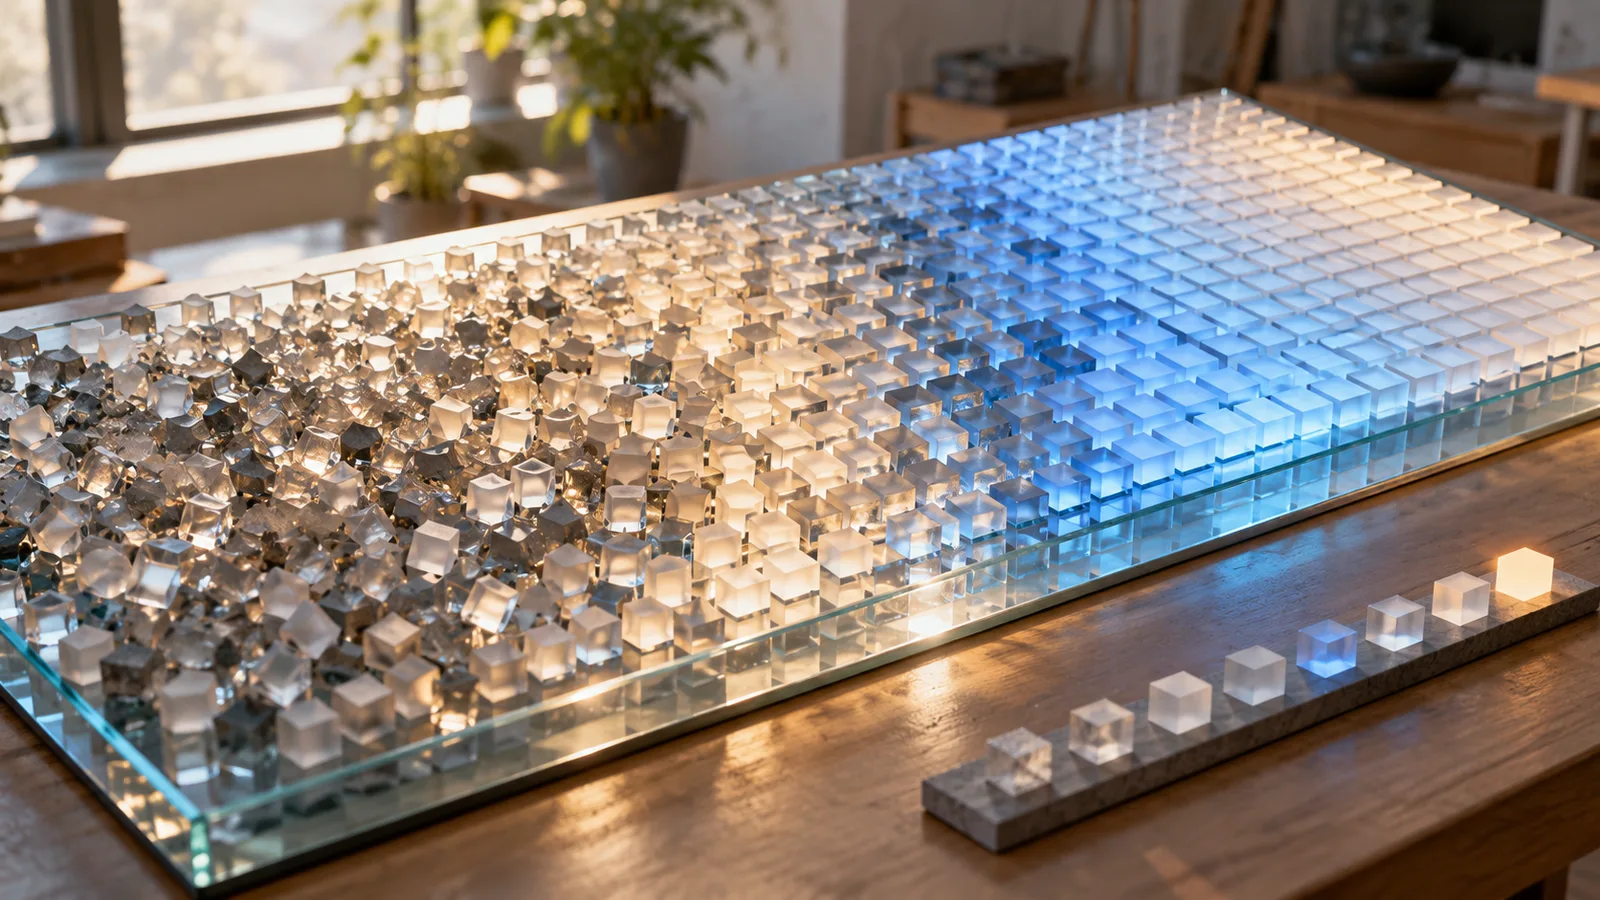
AI ส่วนใหญ่เขียนทีละคำ แต่ DiffusionGemma ร่างทั้งหน้าก่อน แล้วค่อยขัดให้ชัด ✍️
โมเดลภาษาทั่วไป (อย่าง Gemma 4) ต้องคิด 1 รอบ ได้ 1 token คำถัดไปต้องรอคำก่อนหน้าเสมอ
DiffusionGemma ที่ Google เปิดตัวเมื่อ 10 มิ.ย. 2026 ทำอีกแบบ: เริ่มจากผืนผ้าใบที่เต็มไปด้วยคำสุ่ม 256 tokens แล้วขัดหลายรอบ คำที่มั่นใจถูกล็อกก่อน แล้วใช้เป็นเบาะแสเติมคำที่เหลือ
ผลคือเร็วขึ้นสูงสุด 4 เท่า (1000+ tokens/วินาที บน NVIDIA H100)
แต่ต้องแลก: คะแนน MMLU Pro 77.6% เทียบ Gemma 4 ที่ 82.6% — Google บอกเองว่าคุณภาพโดยรวมต่ำกว่า
แล้วใช้ตัวไหนดี?
งานที่ต้องแม่นที่สุด → Gemma 4
แก้ข้อความสด ๆ ลองซ้ำเร็ว ๆ → DiffusionGemma
อีกข้อที่ต้องรู้: ความเร็วนี้ได้เต็มที่ตอนรันเองบนการ์ดจอ คนใช้ไม่มาก ถ้าเปิดให้คนจำนวนมากใช้บนคลาวด์ ข้อได้เปรียบจะลดลง
ประโยคในคลิปเป็นภาพประกอบอธิบายกลไก ไม่ใช่ผลรันจริง
ถ้าเลือกได้ งานของคุณอยากได้เร็ว หรือแม่น?
ที่มาของตัวเลข
https://blog.google/innovation-and-ai/technology/developers-tools/diffusion-gemma-faster-text-generation/
https://huggingface.co/google/diffusiongemma-26B-A4B-it
ไม่ได้รันโมเดลเอง ตัวเลขทั้งหมดเป็นของ Google
เร็วขึ้นสูงสุด 4 เท่า · 1000+ tokens/s บน H100 · 256 tokens พร้อมกัน — Google Blog (10 มิ.ย. 2026)
MMLU Pro 77.6% (DiffusionGemma) vs 82.6% (Gemma 4) — model card ของ Google บน Hugging Face
- DiffusionGemma
- diffusion language model
- text diffusion
- Gemma 4
- Google Gemma
- autoregressive