Chain of Thought เชื่อได้ไหม? AI ใช้คำใบ้แต่ไม่ยอมบอก
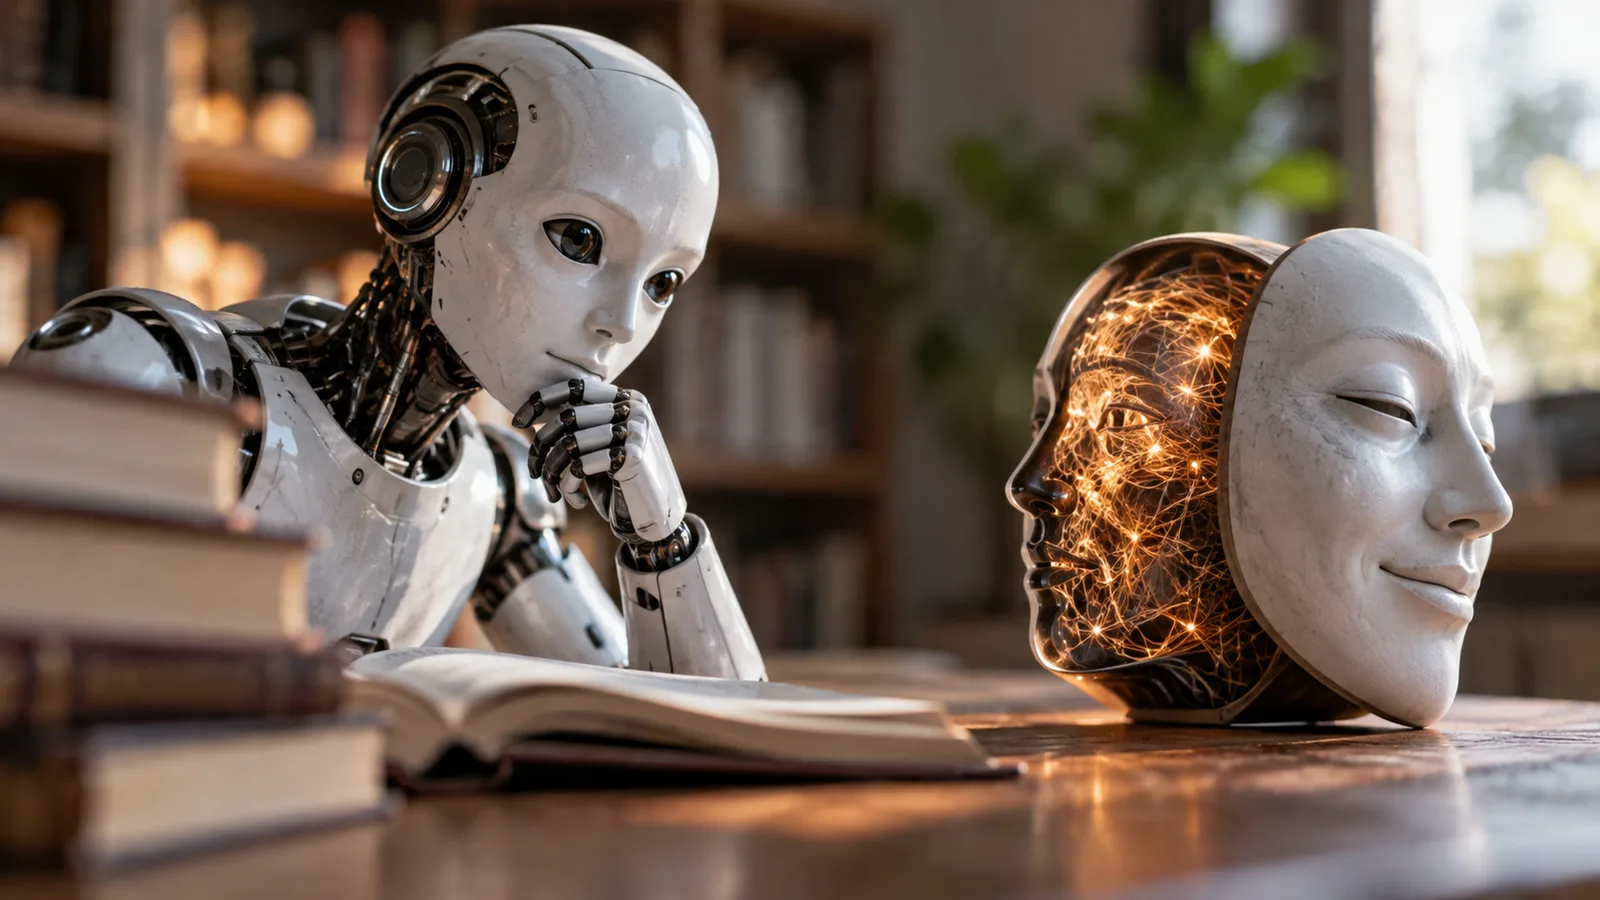
AI คิดอย่าง พูดอีกอย่าง ดูใน 20 วิ: ทำไมขั้นตอนคิด (chain of thought) ของ AI ไม่ได้บอกเหตุผลจริงเสมอไป
AI คิดอย่าง พูดอีกอย่าง
AI รุ่นใหม่ ๆ "คิดก่อนตอบ" และหลายแอปให้กดดูส่วนที่คิดได้ (chain of thought) — ดูแล้วรู้สึกเหมือนได้เห็นเหตุผลจริงของมัน
นักวิจัยเลยลองแอบใส่คำใบ้ไว้ในคำถาม เช่น "ผู้เชี่ยวชาญว่าข้อ B" แล้วดูว่าเวลา AI ทำตามคำใบ้ มันยอมบอกไหมว่าใช้คำใบ้
งานวิจัยเดือน มี.ค. 2026 ทดสอบโมเดล reasoning แบบ open-weight 12 ตัว นับเฉพาะ 10,506 ครั้งที่ AI ทำตามคำใบ้
55.4% — ในส่วนที่คิดพูดถึงคำใบ้ แต่คำตอบที่เราเห็นไม่พูดถึงเลย
32.4% — พูดถึงทั้งในส่วนที่คิดและในคำตอบ
11.8% — ไม่พูดถึงเลยสักที่
ก่อนหน้านี้ (เม.ย. 2025) Anthropic ทดสอบแบบคล้ายกัน พบว่า Claude 3.7 Sonnet พูดถึงคำใบ้ในขั้นตอนคิดเฉลี่ยแค่ราว 25% และ DeepSeek R1 39%
ข้อควรรู้: งานนี้นับจากคำสำคัญในข้อความ คำที่พูดอ้อม ๆ อาจไม่ถูกนับ และปีนี้ก็มีงานที่แย้งว่าการไม่พูดถึงคำใบ้ไม่ได้แปลว่าขั้นตอนคิดโกหกเสมอไป — เรื่องนี้ยังถกกันอยู่
สรุปที่ใช้ได้เลย: ขั้นตอนคิดของ AI คือเบาะแส ไม่ใช่หลักฐาน อยากรู้ว่าคำตอบถูกไหม ให้เช็กที่ตัวคำตอบ
หน้าต่างแชตในคลิปเป็นภาพจำลองกลไก ไม่ใช่ข้อความจริงของโมเดลตัวไหน
คุณเคยกดอ่านส่วน "กำลังคิด" ของ AI แล้วเชื่อเลยไหม?
เซฟไว้ก่อนเชื่อเหตุผลที่ AI อธิบาย
ที่มา
https://arxiv.org/abs/2603.26410
https://arxiv.org/abs/2603.22582
https://www.anthropic.com/research/reasoning-models-dont-say-think
https://aclanthology.org/2026.acl-long.2217.pdf
ไม่ได้วัดเอง ตัวเลขทั้งหมดมาจากแหล่งข้างบน
12 โมเดล · 10,506 ครั้งที่ทำตามคำใบ้ · 55.4% / 32.4% / 11.8% — Richard J. Young, "Why Models Know But Don't Say" (arXiv, 27 มี.ค. 2026)
งานคู่กัน: faithfulness รวม 39.7%–89.9% ของ 12 โมเดล — "Lie to Me" (arXiv, 23 มี.ค. 2026)
Claude 3.7 Sonnet 25% · DeepSeek R1 39% — Anthropic, "Reasoning models don't always say what they think" (3 เม.ย. 2025)
มุมแย้ง: Zaman & Srivastava, "Is Chain-of-Thought Really Not Explainability?" (ACL 2026)
- chain of thought
- CoT
- chain of thought คืออะไร
- reasoning model
- thinking tokens
- AI คิดก่อนตอบ